可视化大屏的底层架构 分布式数据处理与高性能渲染技术揭秘
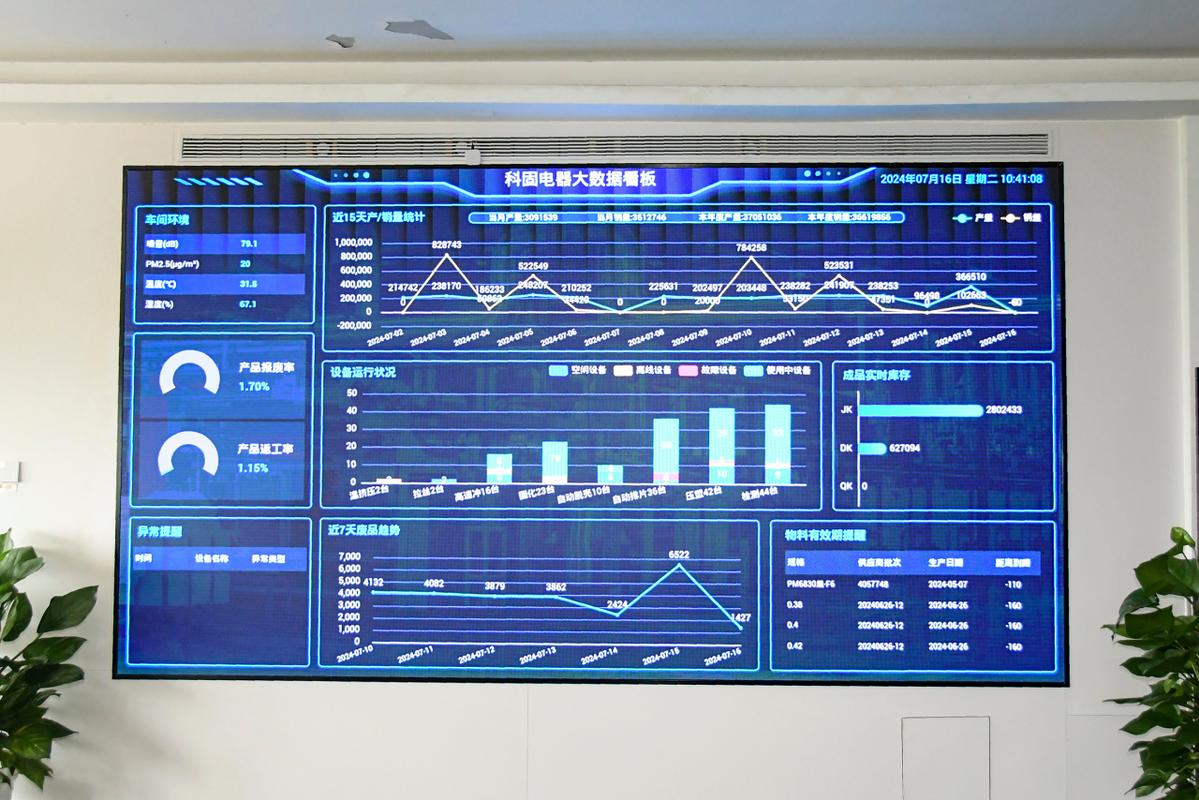
在数字化转型的浪潮中,可视化大屏作为数据呈现的核心载体,已广泛应用于指挥调度、监测预警、業務分析等场景。一块流畅、实时、高清的大屏背后,离不开两大技术支柱:分布式数据处理与高性能渲染。本文将从架构视角深入剖析这两大引擎,揭示其协同工作的奥秘。\n\n## 一、分布式数据处理:从海量数据到实时洞察\n\n可视化大屏需要接入多源异构数据,并保证高并发下的低延迟更新。传统单机处理模式难以胜任,因此采用分布式数据处理架构。该架构通常分为数据采集、流式计算、存储与查询四个层次。\n\n数据采集层:通过Agent、SDK或API对接数据库、消息队列、IoT设备等,实现数据的实时抽取与清洗。增量采集与CDC(变更数据捕获)技术确保数据时效性。\n\n流式计算层:以Flink、Spark Streaming为代表的计算引擎,对数据流进行窗口聚合、规则匹配、复杂事件处理等。例如,某电商大屏需要实时统计GMV,流计算任务每5秒触发一次滚动窗口计算,结果推送到下游。\n\n存储与查询层:采用混合存储策略。时序数据库(如TDengine)存储指标数据,分析型数据库(如ClickHouse)支撑多维查询,Redis缓存热点结果。查询时通过分布式SQL引擎压接数据,并支持预聚合与索引优化。\n\n关键设计:为避免数据倾斜,采用哈希与范围分片结合的设备;针对高可用,利用ZooKeeper或Kubernetes实现任务容错与弹性伸缩。\n\n参考配置示例(提高清晰度和专业性):\n\n- Spark/Flink并发度(parallelism):通常配置为20\n- 窗口计算与数据有效期(流计算):窗口为65任意以类型为准;数据可能会不断被重用自。\n
如若转载,请注明出处:http://www.quboluo.com/product/107.html
更新时间:2026-11-07 08:47:29